一、环境与现象#
1.1 环境信息#
| 项目 | 值 |
|---|
| OS | CentOS 7 |
| Kernel | 3.10.0-1160.119.1.el7.x86_64 |
| 容器编排 | K3s (内置 containerd) |
| CNI | Flannel |
1.2 故障现象#
在之前客户环境升级组件时,经常有pod长期处于Terminating状态导致无法升级的情况
我在相同内核版本的测试机复现了这个环境,升级后出现多个 Pod 长时间卡在 Terminating 状态无法销毁,新 Pod 处于 Pending:
1
2
3
4
5
6
7
8
9
| $ kubectl get pods | grep -E "Terminating|Pending"
spark-job-engine-controller-c46bfcc7d-vtpdj 0/1 Pending 0 25h
langfuse-worker-8588567885-vxkxw 0/1 Terminating 7 8d
analytics-server-controller-7bcf876764-mkg2w 0/1 Terminating 4 8d
langfuse-redis-6c5b76587f-4jj26 0/1 Terminating 4 8d
langfuse-web-b4bf858d8-2l4xv 0/1 Terminating 11 8d
grafana-controller-59cc7fd9bd-dpb7t 0/1 Terminating 4 12d
spark-job-engine-controller-c46bfcc7d-xr2g4 0/1 Terminating 2 5d19h
analytics-admin-controller-6fb9f7c5b5-ppv2h 0/1 Terminating 7 12d
|
1.3 Kubelet 报错#
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
| $ journalctl -u k3s --no-pager -n 500 | grep "device or resource busy"
E0331 11:27:25.242419 kuberuntime_manager.go:1040] "PodSandboxStatus of sandbox for pod"
err="...remove netns: unlinkat /var/run/netns/cni-4c32477c-303b-b39b-d8df-d94fae2326ff:
device or resource busy"
pod="default/spark-job-engine-controller-c46bfcc7d-xr2g4"
E0331 11:27:25.242649 kuberuntime_manager.go:1040] "PodSandboxStatus of sandbox for pod"
err="...remove netns: unlinkat /var/run/netns/cni-d45c9dbd-42b7-e043-17ff-d4881623b543:
device or resource busy"
pod="default/langfuse-redis-6c5b76587f-4jj26"
# ...其余 4 个 Pod 报同样的错误
|
共 6 个不同的 netns 文件触发 EBUSY,对应 6 个不同的 Pod。
补充说明:什么是 EBUSY?
EBUSY (Device or resource busy) 是 Linux 系统调用返回的错误码。如果在进程层面上尝试对文件、挂载点或设备执行删除(unlink)、卸载(umount)等操作时,内核发现该目标正被其他活跃进程、内核子系统或其他 Namespace 强引用占用着,就会强制拒绝操作并抛出此错误。
补充说明:什么是 unlinkat?
unlinkat 是 Linux 内核中的一个系统调用,用于删除文件或解除目录项链接。在此场景中,由于每个 Pod 都有独立的网络命名空间(netns),容器运行时在销毁 Pod 时会调用 unlinkat 来删除位于 /var/run/netns/ 下对应的网络隔离文件。如果该文件仍在其他 Mount Namespace 中被当做挂载点引用,unlinkat 就会遭到内核拒绝并返回上述的 EBUSY。
二、初始假设:内核 veth 引用计数泄漏#
2.1 推理过程#
一开始问Gemini,它说CentOS 7 的 3.10 内核有一个著名的已知问题:veth 虚拟网卡在销毁时,nf_conntrack、IPv6 或路由缓存等子系统可能因竞态条件无法及时释放对 net_device 的引用计数,导致 unregister_netdevice 卡住,表现为 netns 无法删除。
但是我用lsof和fuser -m看这些nets文件没问题,那似乎只能是内核态问题。
2.2 准备 SystemTap 追踪#
基于这个假设,我让AI帮我编写了一个 SystemTap 脚本 hook dev_hold/dev_put(其实要不是内核太老,我都想用ebpf来做),计划抓取 veth 的引用泄漏调用栈:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
| # veth_refcount_trace.stp (简化)
# 定义一个全局数组,用于统计每个调用栈的引用计数增减情况
global hold_stacks
# 探针 1:当内核调用 dev_hold(增加网络设备引用计数)时触发
probe kernel.function("dev_hold") {
# 将内核结构体中的设备名指针转换为字符串
devname = kernel_string($dev->name)
# @1 代表执行脚本时传入的第一个参数(即我们要追踪的 veth 网卡名)
if (devname == @1) {
# 获取当前的内核调用栈(backtrace),并将其在数组中的计数 +1
hold_stacks[backtrace()] ++
}
}
# 探针 2:当内核调用 dev_put(减少网络设备引用计数)时触发
probe kernel.function("dev_put") {
devname = kernel_string($dev->name)
if (devname == @1) {
# 获取当前的内核调用栈,并将其在数组中的计数 -1
hold_stacks[backtrace()] --
}
}
# 探针 3:在 SystemTap 脚本结束(例如按下 Ctrl+C 停止抓取)时触发
probe end {
# 遍历我们记录的所有调用栈('hold_stacks-' 表示按计数值降序排列)
foreach (bt in hold_stacks-)
# 如果某个调用栈的最终计数 > 0,说明 `dev_hold` 的次数多于 `dev_put`
# 这就意味着这个调用栈存在“借了不还”的引用泄漏行为
if (hold_stacks[bt] > 0) {
# 打印出这个“罪魁祸首”的内核调用栈详情,方便定位是哪个内核模块的锅
print_syms(bt)
}
}
|
补充说明:脚本逻辑解析
这段 SystemTap 脚本的核心逻辑是**“查账”**。Linux 内核通过 dev_hold (拿走一个引用) 和 dev_put (归还一个引用) 来管理网络设备的生命周期。
通过在这个借还的关口设下探针,我们把每次操作的“指纹”(即发生调用的内核堆栈 backtrace)记录并相互抵消。最后进程退出时对一算账,凡是差额大于 0 的,就一定是引起内核对象泄漏的源头代码。
2.3 假设开始动摇#
在准备运行 SystemTap 之前,做了两个关键检查:
检查 1:dmesg 没有 unregister_netdevice 消息
1
2
| $ dmesg | grep -i "unregister_netdevice\|waiting for veth"
# (空!没有任何输出)
|
补充说明:什么是 unregister_netdevice(未注销的网络设备)?
unregister_netdevice 是 Linux 内核中负责从网络协议栈中彻底注销并移除网络设备(例如 veth 虚拟网卡)的内部接口。当容器被销毁时,内核需要卸载这块网卡;但如果该网卡还被其他内核模块(如网络连接跟踪 nf_conntrack、路由缓存等)持有引用且未释放,内核就无法将其安全移除,此时就会陷入死循环并不断在 dmesg 中打印等待释放的日志。
如果是经典的 veth 引用泄漏,dmesg 中一定会有 unregister_netdevice: waiting for vethXXXX to become free 的循环告警。没有这个消息,说明 veth 设备本身已经正常销毁,问题不在设备引用层。
检查 2:nsenter 进入 netns 失败
1
2
| $ nsenter --net=/var/run/netns/cni-4c32477c-303b-b39b-d8df-d94fae2326ff ip link
nsenter: reassociate to namespace 'ns/net' failed: Invalid argument
|
补充说明:什么是 nsenter?
nsenter (Namespace enter) 是一个用来打破环境隔离、让指定的程序连接/进入到已存在的 Linux Namespace 中的命令行工具。在网络排查中,常用来通过 nsenter --net=<文件路径> 强行“钻入”容器的网络命名空间内,从而在宿主机上拥有和目标容器完全一样的网络视图来执行 ip link 或抓包等命令。
EINVAL 说明这个文件已经不再是一个有效的 network namespace 引用——内核中对应的 netns 对象已经释放,但文件本身却删不掉。
到这里,假设已经基本被推翻:这不是内核 netns/veth 对象泄漏的问题,而是文件系统层面有什么东西阻止了 unlinkat()。
三、转换方向:为什么 rm 和 umount 都失败?#
3.1 在宿主上测试删除和卸载#
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
| $ rm -f /var/run/netns/cni-4c32477c-303b-b39b-d8df-d94fae2326ff
rm: cannot remove '...': Device or resource busy
$ umount /var/run/netns/cni-4c32477c-303b-b39b-d8df-d94fae2326ff
umount: ...: not mounted
$ file /var/run/netns/cni-4c32477c-303b-b39b-d8df-d94fae2326ff
/var/run/netns/cni-4c32477c-...: empty
$ mountpoint /var/run/netns/cni-4c32477c-303b-b39b-d8df-d94fae2326ff
mountpoint: ...: not a directory
|
矛盾点出现了:
rm 报 EBUSYumount 说 “not mounted”file 说它是空文件mountpoint 说它不是挂载点
在宿主 mount namespace 中,它确实不是 mount point。那 EBUSY 从何而来?
3.2 跨 Mount Namespace 搜索#
EBUSY on unlinkat() 在 Linux VFS 中的触发条件之一是:目标文件在某个(任何)mount namespace 中是 mount point。不一定是当前的 mount namespace。
1
2
3
| $ grep -r "cni-4c32477c" /proc/*/mountinfo 2>/dev/null | head -5
/proc/6281/mountinfo:1816 1793 0:3 / /root-disk/run/netns/cni-4c32477c-303b-... - proc proc rw
/proc/6389/mountinfo:1816 1793 0:3 / /root-disk/run/netns/cni-4c32477c-303b-... - proc proc rw
|
找到了! PID 6281 和 6389 的 mount namespace 中,这个 netns 文件仍然被挂载。
3.3 确认持有进程身份#
1
2
3
4
5
| $ ps -fp 6281 6389 6142
UID PID PPID CMD
root 6281 6142 /bin/node_exporter --web.listen-address=:9200 --collector.filesystem...
root 6389 6142 crond -b
root 6142 1 /home/analytics/docker/k3s/data/19eadf174fb6dfb5a92b12cd3045d81...
|
PID 6281 是 node_exporter(Prometheus 监控采集器),PID 6389 是 crond,都运行在同一个监控容器 (node-exporter-controller) 中,父进程 PID 6142 是 containerd-shim,还有这个PPID 是1的应该都知道这是什么吧(容器的第一个进程)
1
2
| $ kubectl get pods -A | grep node.exporter
default node-exporter-controller-vhpgr 2/2 Running 8 (25h ago) 12d
|
3.4 容器 Mount Namespace 全貌#
查看 PID 6281 的 mountinfo,发现 6 个卡死的 netns 全部在列:
1
2
3
4
5
6
7
| $ cat /proc/6281/mountinfo | grep "netns"
1803 ... /root-disk/run/netns/cni-e182a2f0-... - proc proc rw
1813 ... /root-disk/run/netns/cni-d3eadf16-... - proc proc rw
1816 ... /root-disk/run/netns/cni-4c32477c-... - proc proc rw
1825 ... /root-disk/run/netns/cni-bb716a75-... - proc proc rw
1857 ... /root-disk/run/netns/cni-d45c9dbd-... - proc proc rw
1869 ... /root-disk/run/netns/cni-d4c47fb3-... - proc proc rw
|
路径都是 /root-disk/run/netns/cni-xxx——说明监控容器把宿主的 /var/run 挂载为 /root-disk/run。
同时宿主 PID 1 的 mountinfo 中,正常的 netns 挂载条目带有 shared:5 标记:
1
2
| $ grep "netns" /proc/1/mountinfo | head -1
79 24 0:3 / /run/netns/cni-704a577c-... rw,nosuid,nodev,noexec,relatime shared:5 - proc proc rw
|
shared:5 意味着这些挂载使用了 shared propagation(共享传播模式),在这个挂载点目录下发生的任何新增子目录挂载事件,都会被内核自动同步映射到共享该挂载点的其他 Namespace 成员中。
补充说明:什么是 shared:5 与“子 mount 传播”?
这是基于 Linux Mount Namespace 的共享机制。shared:5 表示挂载点处于“共享模式”(Peer Group ID 为 5),组内的挂载变化会自动跨 Namespace 同步。
具体到本案例的传播过程:
监控组件挂载了宿主机的 /(如挂载到容器内 /hostfs),两者相当于建立了“镜像挂载管线”。
当 Kubelet 在宿主机上为其他业务 Pod 准备资源(例如在 /var/... 下挂载网络文件或数据卷)时,由于父目录 / 是 shared 模式,内核会将宿主机上的这一新挂载动作,自动在监控容器内复制一份。
结论:只要监控组件以 shared 模式挂载了根目录 /,此节点上所有新建 Pod 的各类挂载点,都会被内核“强制抄送”一份给监控组件。这使得监控容器被动持有了全节点 Pod 的资源引用,从而在 Pod 销毁清理时触发 EBUSY 阻塞。
四、根因确认#
至此,该问题的触发链条已完全清晰:
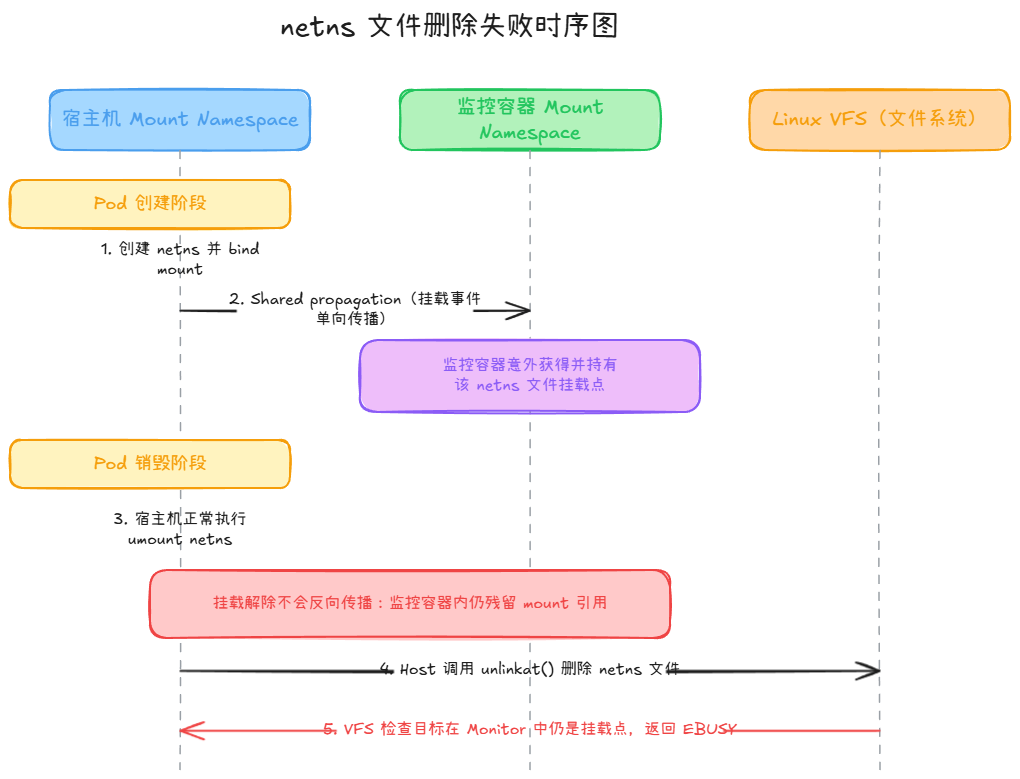
核心机制如下:
- 业务配置触发:以
node_exporter 为例,其 DaemonSet 中使用了 hostPath,将宿主机的根目录 / 映射到了容器内部:1
2
3
4
| volumes:
- name: rootfs
hostPath:
path: /
|
- 挂载事件的单向泄露:除了挂载宿主机根目录,YAML 中同时配置了
privileged: true 和 hostPID: true。在这种高权限下,监控容器继承了宿主机的 shared mount propagation 属性。这导致 K3s 在宿主机为其他普通 Pod 创建 netns 挂载点时,这些挂载事件被同步传播到了监控容器的 mount namespace 中。 - 清理操作的不对称:K3s 销毁 Pod 时,会在宿主的 mount namespace 中执行 umount。但这仅仅解除了宿主机的挂载,监控容器由于没有被触发反向清理,其内部依然维持着对这些对象的挂载引用。
- 内核机制与 EBUSY 报错:CentOS 7 的 Linux 3.10 内核因默认
fs.may_detach_mounts = 0,VFS 在执行 unlinkat() 删除文件时,会检查所有 mount namespace。发现监控容器仍持有该 netns 文件的 mount 引用后,内核直接拒绝删除并返回 EBUSY。
不只是 netns 文件,Pod Sandbox 的 /shm tmpfs、overlay rootfs 以及 kubelet projected volume 等组件,也都通过完全相同的机制泄露到了监控容器内,形成了导致 Pod 无法销毁的阻塞。
五、修复过程(局部手动清理)#
如果你不想影响监控组件的运行,想做“局部精准清理”,就会遇到下面这些折腾的操作:
5.1 尝试 nsenter 直接 umount 特定目录(局部清理,失败)#
1
2
| $ nsenter -m -t 6281 umount /root-disk/run/netns/cni-4c32477c-303b-b39b-d8df-d94fae2326ff
nsenter: failed to execute umount: No such file or directory
|
容器是最小化镜像,内部没有 umount 二进制文件。
5.2 Python + ctypes 直接系统调用(局部清理,成功,其实kubectl delete就行了不用这么麻烦)#
绕过容器内缺少工具的问题,用 Python 直接调用 setns() 进入目标 mount namespace,再用 umount2() 执行 lazy unmount:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
| import ctypes, ctypes.util, os
libc = ctypes.CDLL(ctypes.util.find_library('c'), use_errno=True)
CLONE_NEWNS = 0x00020000
MNT_DETACH = 2 # lazy unmount
target_pid = 6281
stuck_netns = [
'cni-4c32477c-303b-b39b-d8df-d94fae2326ff',
'cni-d45c9dbd-42b7-e043-17ff-d4881623b543',
'cni-d3eadf16-2c9c-641e-9153-86f5133f16dd',
'cni-e182a2f0-7969-a649-670a-1539c2a62969',
'cni-d4c47fb3-1e11-ec8f-9174-2a266927ad65',
'cni-bb716a75-cd31-bceb-18d6-83c5fe827a6e',
]
# 保存原始 mount namespace
orig_ns_fd = os.open('/proc/self/ns/mnt', os.O_RDONLY)
# 进入目标容器的 mount namespace
fd = os.open(f'/proc/{target_pid}/ns/mnt', os.O_RDONLY)
libc.setns(fd, CLONE_NEWNS)
os.close(fd)
# Lazy unmount 每个卡死的 netns
for ns in stuck_netns:
path = f'/root-disk/run/netns/{ns}'.encode()
ret = libc.umount2(path, MNT_DETACH)
print(f"{'OK' if ret == 0 else 'FAIL'}: {ns}")
# 返回原始 mount namespace
libc.setns(orig_ns_fd, CLONE_NEWNS)
os.close(orig_ns_fd)
|
执行结果:
1
2
3
4
5
6
7
8
| Entered mount namespace of PID 6281
OK: lazy-unmounted cni-4c32477c-303b-b39b-d8df-d94fae2326ff
OK: lazy-unmounted cni-d45c9dbd-42b7-e043-17ff-d4881623b543
OK: lazy-unmounted cni-d3eadf16-2c9c-641e-9153-86f5133f16dd
OK: lazy-unmounted cni-e182a2f0-7969-a649-670a-1539c2a62969
OK: lazy-unmounted cni-d4c47fb3-1e11-ec8f-9174-2a266927ad65
OK: lazy-unmounted cni-bb716a75-cd31-bceb-18d6-83c5fe827a6e
Returned to original mount namespace
|
6 个 netns 文件随后被成功 rm 删除。
5.3 清理第二层:sandbox shm/rootfs + kubelet volume#
补充说明:什么是 shm?
shm (Shared Memory,共享内存) 是 Linux 提供的一种允许不同进程访问同一块内存区域以进行高速通信的机制。在容器环境中,/dev/shm 通常被挂载为一个基于内存的 tmpfs 临时文件系统。由于它也是一个挂载点,因此在 Pod 创建时,这个 shm 挂载点也会被 K8s 创建,并且基于上述同样的 shared 传播机制偷渡滞留到了监控容器中。
netns 清理后,K3s 日志显示新的 EBUSY 层——sandbox 的 /shm 和 kubelet projected volume 也被同样机制阻塞。用相同方式扫描并清理:
1
2
3
4
5
6
7
8
| Found 13 stale mounts to clean:
/root-disk/run/k3s/containerd/.../710bbd14.../shm
/root-disk/var/lib/kubelet/pods/0fa395f2-.../kube-api-access-mn68b
/root-disk/var/lib/kubelet/pods/e243c5b9-.../analytics-server/0
/root-disk/var/lib/kubelet/pods/e243c5b9-.../analytics-server/1
... (共 13 个)
Done. OK=13, FAIL=0
|
5.4 Force Delete 残留 Pod#
清理完所有 stale mount 后,K3s 不再报 EBUSY 错误。Force delete 加速 Pod 回收:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
| $ kubectl delete pod -n default --force --grace-period=0 \
langfuse-worker-8588567885-vxkxw \
analytics-server-controller-7bcf876764-mkg2w \
langfuse-redis-6c5b76587f-4jj26 \
langfuse-web-b4bf858d8-2l4xv \
grafana-controller-59cc7fd9bd-dpb7t \
spark-job-engine-controller-c46bfcc7d-xr2g4
pod "langfuse-worker-8588567885-vxkxw" force deleted
pod "analytics-server-controller-7bcf876764-mkg2w" force deleted
pod "langfuse-redis-6c5b76587f-4jj26" force deleted
pod "langfuse-web-b4bf858d8-2l4xv" force deleted
pod "grafana-controller-59cc7fd9bd-dpb7t" force deleted
pod "spark-job-engine-controller-c46bfcc7d-xr2g4" force deleted
|
所有 Pod 恢复 Running。
六、最终解决方案与预防#
6.1 临时救急方案:直接重启/卸载监控容器#
按照前面的根因推导过程:既然所有的“强制引用”都被保存在监控容器的 Mount Namespace 里,那么在不修改内核参数、不升级系统的前提下,最快解决 Pod 卡死的办法就是:直接干掉相关的监控容器
只要监控容器被销毁,它的 Mount Namespace 就会灰飞烟灭,所有偷偷保留的子挂载点引用也会被内核立刻整体回收。此时 Kubelet 再去清理那些卡在 Terminating 的业务 Pod,就不会再遇到 EBUSY 被阻断,Pod 瞬间就能全部成功释放。
6.2 快速缓解:设置 fs.may_detach_mounts = 1#
1
2
| sysctl -w fs.may_detach_mounts=1
echo "fs.may_detach_mounts = 1" >> /etc/sysctl.conf
|
原理:该参数是 CentOS 7 的 3.10 backport 内核特有的 sysctl。默认值为 0 时,unlinkat() 会检查目标文件是否在任何 mount namespace 中被用作 mount point,如果是则返回 EBUSY。设置为 1 后,内核会在 unlinkat() 时自动对其他 mount namespace 中的 stale mount 执行 lazy detach,然后允许删除操作继续。
注:主线 4.x+ 内核默认行为已等效于 = 1,不再需要此参数。
6.3 长期方案:升级内核#
CentOS 7 的 3.10 内核在容器 mount namespace 场景下有多个已知问题。按照之前有个文档升级下内核也行
6.4 深层追问:为什么宿主挂载默认就是 shared?#
细心的读者可能会问:为什么 /var/run/netns/cni-xxx 这些 bind mount 一创建就自带 shared 传播属性?答案藏在 systemd 里。
systemd 在早期启动阶段会执行 mount --make-rshared /,将根目录及所有子挂载递归设为 shared propagation。这可以直接验证:
1
2
3
4
| $ awk '$5=="/" {print}' /proc/1/mountinfo
40 0 253:1 / / rw,relatime shared:1 - ext4 /dev/vda1 rw,data=ordered
^^^^^^^^
根挂载带着 shared:1
|
systemd 这么做是为了支持自身的服务沙箱特性(PrivateMounts=、ProtectSystem= 等),这些特性依赖 mount namespace 间的事件传播。这意味着 / 之下创建的任何新挂载都会自动继承 shared 属性,包括 K3s 在 /var/run/netns/ 下创建的 netns bind mount。
所以,这个问题的完整事故实际上涉及三个组件:

一个常见的误解是"现代 Debian/Ubuntu 系统不存在这个问题是因为 systemd 改了行为"。事实上,现代系统的 systemd 同样会 mount --make-rshared /,根挂载同样是 shared。真正消除问题的是内核侧的修复:主线 4.x+ 内核在 unlinkat() 时会自动对跨 namespace 的 stale mount 执行 lazy detach(等效于 fs.may_detach_mounts = 1 被硬编码),sysctl 开关本身也被移除了。
换言之:同样的 systemd shared propagation + 同样的 Bidirectional 容器配置,在新内核上 unlinkat() 直接就能成功,根本不会触发 EBUSY。这个问题本质上是 CentOS 7 的 3.10 内核独有的历史遗留。
